Zabbix pomaga kontrolować działanie serwerów, sieci, aplikacji i usług. Zbiera pomiary, pokazuje zmiany w czasie i powiadamia o problemach, dzięki czemu Twój zespół ma dane potrzebne do diagnozy oraz reakcji.
Zabbix — monitoring infrastruktury, aplikacji i usług
Monitoring, który pomaga zareagować na problem
Gdy sklep przestaje przyjmować zamówienia, sam komunikat o niedostępnej stronie nie wyjaśnia przyczyny. Problem może dotyczyć serwera, bazy danych, sieci albo usługi, od której zależy aplikacja. Zabbix zbiera pomiary z tych elementów i pozwala ustalić warunki, przy których zespół otrzyma powiadomienie.
Możesz wykorzystać go do nadzoru nad pojedynczym serwisem, środowiskiem aplikacji lub infrastrukturą w wielu lokalizacjach. W Okinet możemy pomóc dobrać zakres monitoringu do procesów, które są ważne dla Twojej firmy. Zaczynamy od ustalenia, co powinno działać, jak rozpoznać problem i kto ma na niego zareagować.
Serwery Linux i Windows — obciążenie, pamięć, dyski i procesy
Zabbix pozwala obserwować wykorzystanie procesora, pamięci i przestrzeni dyskowej, a także stan procesów oraz usług. Historia pomiarów ułatwia sprawdzenie, czy wzrost obciążenia był jednorazowy czy powtarza się podczas importu produktów, generowania raportu albo wykonywania kopii zapasowej.
Dane mogą trafiac do systemu przez agenta instalowanego na monitorowanym serwerze. Dostępne są również metody niewymagające agenta, zależnie od sprawdzanej usługi. Wybieramy je tak, aby uzyskać potrzebne informacje przy odpowiednim zakresie uprawnień.
Próg alarmowy dopasowujemy do środowiska. Krótki skok CPU nie zawsze wymaga interwencji, ale utrzymujący się brak wolnego miejsca może szybko zatrzymać zapis danych. Ważna jest zarówno wartość pomiaru, jak i czas trwania niepożądanego stanu.
Sieć i urządzenia — sprawdź, gdzie zanika łączność
Przełączniki, routery i inne urządzenia udostępniają dane, które można zbierać przez SNMP. Zabbix pozwala kontrolować między innymi stan interfejsów, ruch oraz błędy transmisji, o ile urządzenie udostępnia odpowiednie metryki. Testy ICMP i TCP pomagają dodatkowo sprawdzać osiągalność hostów oraz wybranych usług.
Połączenie tych pomiarów ułatwia odróżnienie awarii aplikacji od problemu z łączem. Przy diagnozie liczy się także miejsce wykonywania testu: usługa dostępna z sieci lokalnej może pozostawać niedostępna dla odbiorców z internetu. Dlatego punkty pomiarowe planujemy zgodnie z drogą, którą rzeczywiście docierają użytkownicy.
Bazy danych, aplikacje i integracje — monitoruj ważne zależności
Oficjalny katalog integracji Zabbix zawiera szablony dla wielu baz danych, serwerów WWW i usług chmurowych. Szablon opisuje sposób zbierania danych i gotowe reguły, ale wymaga konfiguracji połączenia oraz sprawdzenia zgodności z używaną wersją. Sama instalacja Zabbix nie uruchamia automatycznie monitoringu wszystkich systemów.
W projekcie opartym na PHP i Symfony możemy dodatkowo przygotować pomiar kolejki zadań, czasu ostatniej udanej synchronizacji lub liczby nieudanych operacji. Takie sygnały pomagają wykryć sytuację, w której strona się otwiera, lecz zaplecze przestało wykonywać ważną pracę.
Dla sklepu lub serwisu na WordPressie warto uwzględnić również bazę danych i zadania cykliczne. Przykładowo brak aktualizacji stanów magazynowych może być istotniejszy biznesowo niż niewielka zmiana obciążenia serwera. Odpowiedni pomiar wymaga udostępnienia tej informacji przez aplikację lub integrację.
Monitoring stron i API — odpowiedź HTTP to początek
Scenariusze WWW pozwalają cyklicznie wykonywać kolejne żądania HTTP i HTTPS. Zabbix mierzy czas odpowiedzi, sprawdza kody odpowiedzi oraz może szukać wymaganej treści. To sposób na weryfikację, czy serwis zwraca oczekiwany wynik, zamiast poprzestawać na sprawdzeniu, czy port sieciowy jest otwarty.
Możesz przygotować scenariusz obejmujący kilka kroków, na przykład wejście na stronę i pobranie wybranego zasobu. Dla API ustalamy osobno, jak rozpoznać odpowiedź poprawną biznesowo. Status 200 nie wystarczy, jeżeli treść zawiera błąd lub nieaktualne dane.
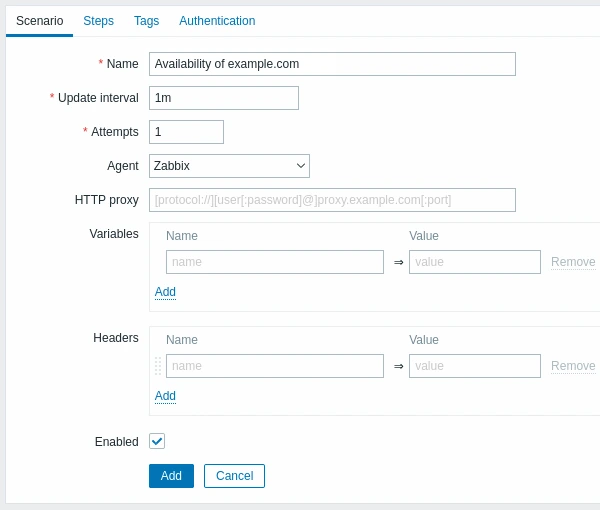
Poniższy przykład pokazuje ustawienia scenariusza: nazwę, częstotliwość i liczbę prób. Konkretne żądania definiuje się w jego krokach. Częstotliwość kontroli dobieramy do znaczenia usługi i kosztu wykonywania testów.
Monitoring w przeglądarce — testuj wybraną ścieżkę użytkownika
Dla procesów zależnych od JavaScript Zabbix udostępnia także pozycje typu Browser. Pozwalają one uruchamiać przygotowane scenariusze przez WebDriver, zbierać pomiary i wykonywać zrzuty ekranu. Wymagają dodatkowego środowiska przeglądarkowego oraz skryptu opisującego test.
Możesz w ten sposób sprawdzać, czy otwiera się formularz, działa logowanie na koncie testowym lub pojawia się oczekiwany element aplikacji. To inny poziom weryfikacji niż pobranie dokumentu HTML. Scenariusz trzeba aktualizować razem ze zmianami interfejsu, a operacje zapisujące dane wykonywać w kontrolowany sposób.
Monitoring syntetyczny sprawdza zdefiniowaną ścieżkę w określonych warunkach. Nie pokazuje wszystkich zachowań rzeczywistych użytkowników i nie zastępuje testów całej aplikacji. Daje za to powtarzalny sygnał, czy wybrany proces nadal działa.
Alerty i eskalacje — informacja powinna trafić do właściwej osoby
W Zabbix reguła wykrywania problemu, czyli trigger, ocenia zebrane dane. Akcja określa, co ma się wydarzyć po spełnieniu warunków. Powiadomienie może trafić do wybranych odbiorców przez skonfigurowany kanał, a dalsze kroki eskalacji zależeć od czasu i stanu obsługi problemu.
Dobry komunikat powinien wskazywać usługę, objaw, moment wystąpienia oraz pierwszą czynność diagnostyczną. Ustalamy też, które zdarzenia wymagają szybkiej reakcji, a które mogą poczekać. Osobna informacja o przywróceniu działania pomaga zamknąć obsługę incydentu.
Powiadomienia testujemy razem z odbiorcami. Warto sprawdzić cały przebieg: wykrycie problemu, dostarczenie wiadomości, reakcję i powrót do prawidłowego stanu. Duża liczba podobnych alarmów bez jasnego właściciela utrudnia pracę, nawet jeśli sam pomiar działa poprawnie.
Dashboardy i mapy — połącz pomiary z kontekstem infrastruktury
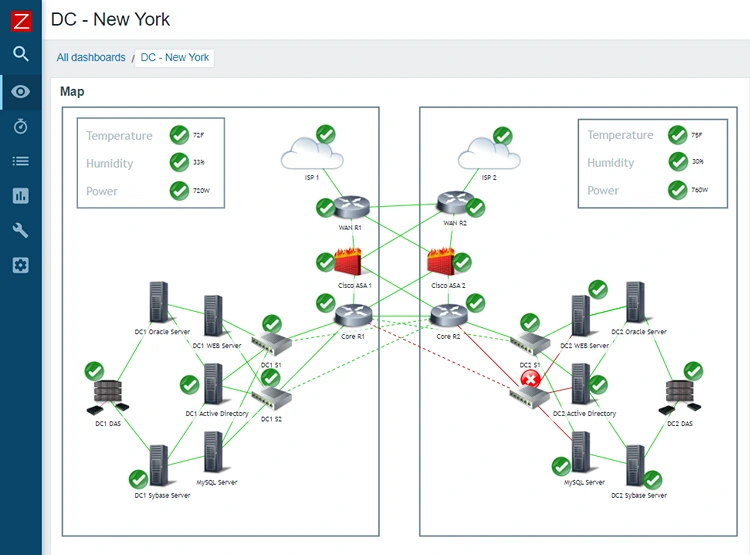
Na dashboardzie możesz zestawić wykresy, aktualne wartości i listę problemów. Mapa pokazuje powiązania między elementami infrastruktury i ich stan. Dzięki temu osoba diagnozująca awarię łatwiej odnajduje urządzenia i usługi związane z niedostępnym fragmentem systemu.
Widok dobieramy do odbiorcy. Administrator potrzebuje szczegółowych metryk, a osoba odpowiedzialna za działanie sklepu — czytelnej informacji o kluczowych usługach. Kilka dobrze dobranych wskaźników bywa bardziej użytecznych niż ekran wypełniony wszystkimi dostępnymi wykresami.
Ilustracja pokazuje fragment przykładowego dashboardu producenta z mapą centrum danych. Jest to materiał prezentacyjny z interfejsu pokazywanego w 2023 roku; układ aktualnej instalacji zależy od wersji i konfiguracji.
Zabbix Proxy — monitoring wielu lokalizacji
Proxy zbiera dane bliżej monitorowanych urządzeń i przekazuje je do głównego serwera Zabbix. Przydaje się w oddziałach, osobnych sieciach lub środowiskach z ograniczoną łącznością. Lokalny bufor pozwala zachować pomiary podczas przejściowej przerwy w komunikacji, w granicach skonfigurowanej retencji i dostępnych zasobów.
Istotny jest podział odpowiedzialności: proxy zbiera i wstępnie przetwarza dane, natomiast główny serwer ocenia triggery i obsługuje alerty. Zachowanie pomiarów w buforze nie oznacza więc, że podczas odcięcia od serwera powiadomienia zostaną wysłane na bieżąco.
Architekturę dobieramy do liczby lokalizacji, dostępności połączeń i znaczenia usług. Oprócz monitorowanych urządzeń trzeba obserwować same proxy oraz opóźnienia w dostarczaniu danych. Brak nowych pomiarów powinien być widocznym problemem, a nie pozornym potwierdzeniem, że wszystko działa.
Usługi i SLA — oceniaj dostępność z perspektywy biznesu
Monitoring usług pozwala powiązać problemy techniczne z usługą, taką jak sklep, portal klienta lub system zamówień. Zabbix umożliwia zbudowanie hierarchii zależności i reguł określających, kiedy problem elementu wpływa na stan całej usługi.
Na tej podstawie można obliczać wskaźniki dostępności i przygotowywać raporty SLA. Najpierw trzeba jednak uzgodnić definicję dostępności, okresy świadczenia usługi i sposób uwzględniania wyłączeń. Wynik raportu opisuje skonfigurowany model oraz dostępne pomiary; nie stanowi automatycznego dowodu spełnienia każdego zapisu umowy.
To użyteczne przy rozmowie o jakości utrzymania. Zamiast oceniać system wyłącznie liczbą alarmów, możesz sprawdzać, jak incydenty wpływały na funkcje istotne dla odbiorców.
Szablony i automatyczne wykrywanie zasobów
Szablony pomagają stosować te same definicje pomiarów, reguły problemów i wykresy na wielu hostach. Zmiana wspólnej konfiguracji może dzięki temu objąć całą grupę podobnych urządzeń. Parametry specyficzne dla danego środowiska trzeba ustawić osobno.
Mechanizmy wykrywania zasobów ułatwiają obejmowanie monitoringiem kolejnych elementów, takich jak systemy plików czy interfejsy sieciowe. W większym środowisku ogranicza to ręczne dodawanie podobnych pomiarów. Reguły wykrywania wymagają jednak filtrów i kontroli, aby nie zbierać danych o elementach, których nie zamierzasz utrzymywać.
Przy wdrożeniu porządkujemy nazwy hostów, grupy i odpowiedzialność za usługi. To ułatwia późniejsze rozwijanie monitoringu oraz przekazywanie opieki nad infrastrukturą między osobami w zespole.
Dostępność samego monitoringu i jego koszty
Monitoring również wymaga utrzymania. Zabbix oferuje mechanizm wysokiej dostępności serwera z węzłem aktywnym i węzłami oczekującymi na przejęcie pracy. Nie rozwiązuje on samodzielnie dostępności bazy danych, panelu WWW ani wszystkich połączeń sieciowych. Te elementy trzeba uwzględnić w projekcie i testach odtwarzania.
Oprogramowanie Zabbix jest dostępne bez opłat licencyjnych; od wersji 7.0 jest wydawane na licencji AGPLv3. Warunki opisuje oficjalna strona licencji. Budżet wdrożenia obejmuje natomiast infrastrukturę, konfigurację, aktualizacje i pracę osób reagujących na zgłoszenia.
Wielkość środowiska zależy nie tylko od liczby serwerów. Znaczenie mają liczba metryk, częstotliwość odczytów, długość przechowywania historii i rodzaj wykonywanych testów. Dlatego zakres i retencję danych ustalamy przed doborem zasobów.
Jak możemy wdrożyć Zabbix w Twoim środowisku
Na początku wybieramy usługi, których niedostępność najbardziej utrudnia pracę firmy. Dla każdej ustalamy sygnały poprawnego działania, źródła danych i osobę odpowiedzialną za reakcję. Następnie dobieramy szablony, przygotowujemy brakujące pomiary i konfigurujemy powiadomienia.
Uruchomienie obejmuje sprawdzenie alertów na kontrolowanych przykładach problemów. Po zebraniu pierwszych danych można skorygować progi, częstotliwość testów i zakres dashboardów. Monitoring rozwija się razem z aplikacją — nowa integracja czy zmiana architektury może wymagać nowych reguł.
Porozmawiajmy o monitoringu Twojej infrastruktury. Możemy zacząć od najważniejszego serwisu i zaplanować kolejne kroki na podstawie tego, co rzeczywiście wymaga nadzoru.